 在计算这个过程时,会遇到以下问题:
如果我们了解attention的基础结构,那么可以了解attention内的基础计算单元的计算过程,由于multihead之间不做交叉运算, 因此简单的看一个head之内的运算, 即QKV矩阵相乘的公式为 :
$$\text{Attention}(Q, K, V) = \text{softmax}\!\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$即矩阵 $Q$ 与键矩阵 $K$ 的转置做点积并除以缩放因子 $\sqrt{d_k}$ 后,经 softmax 归一化得到注意力权重,再与值矩阵 $V$ 相乘,即得到对各位置信息加权聚合后的输出。其中缩放因子是方便计算的标量, 因此先简化来看矩阵乘法的视角: 这里假设Q,K,V 的维度都是 (N,d). K,V通常是相同维度,但是可能与 Q维度不同, 具体情况后面再列举.
值得一提的是, multi-head中的head维度一般不大且固定, 如llama 2 的LLM选择的是128或者56, 方便放入一个 n卡的 block中.
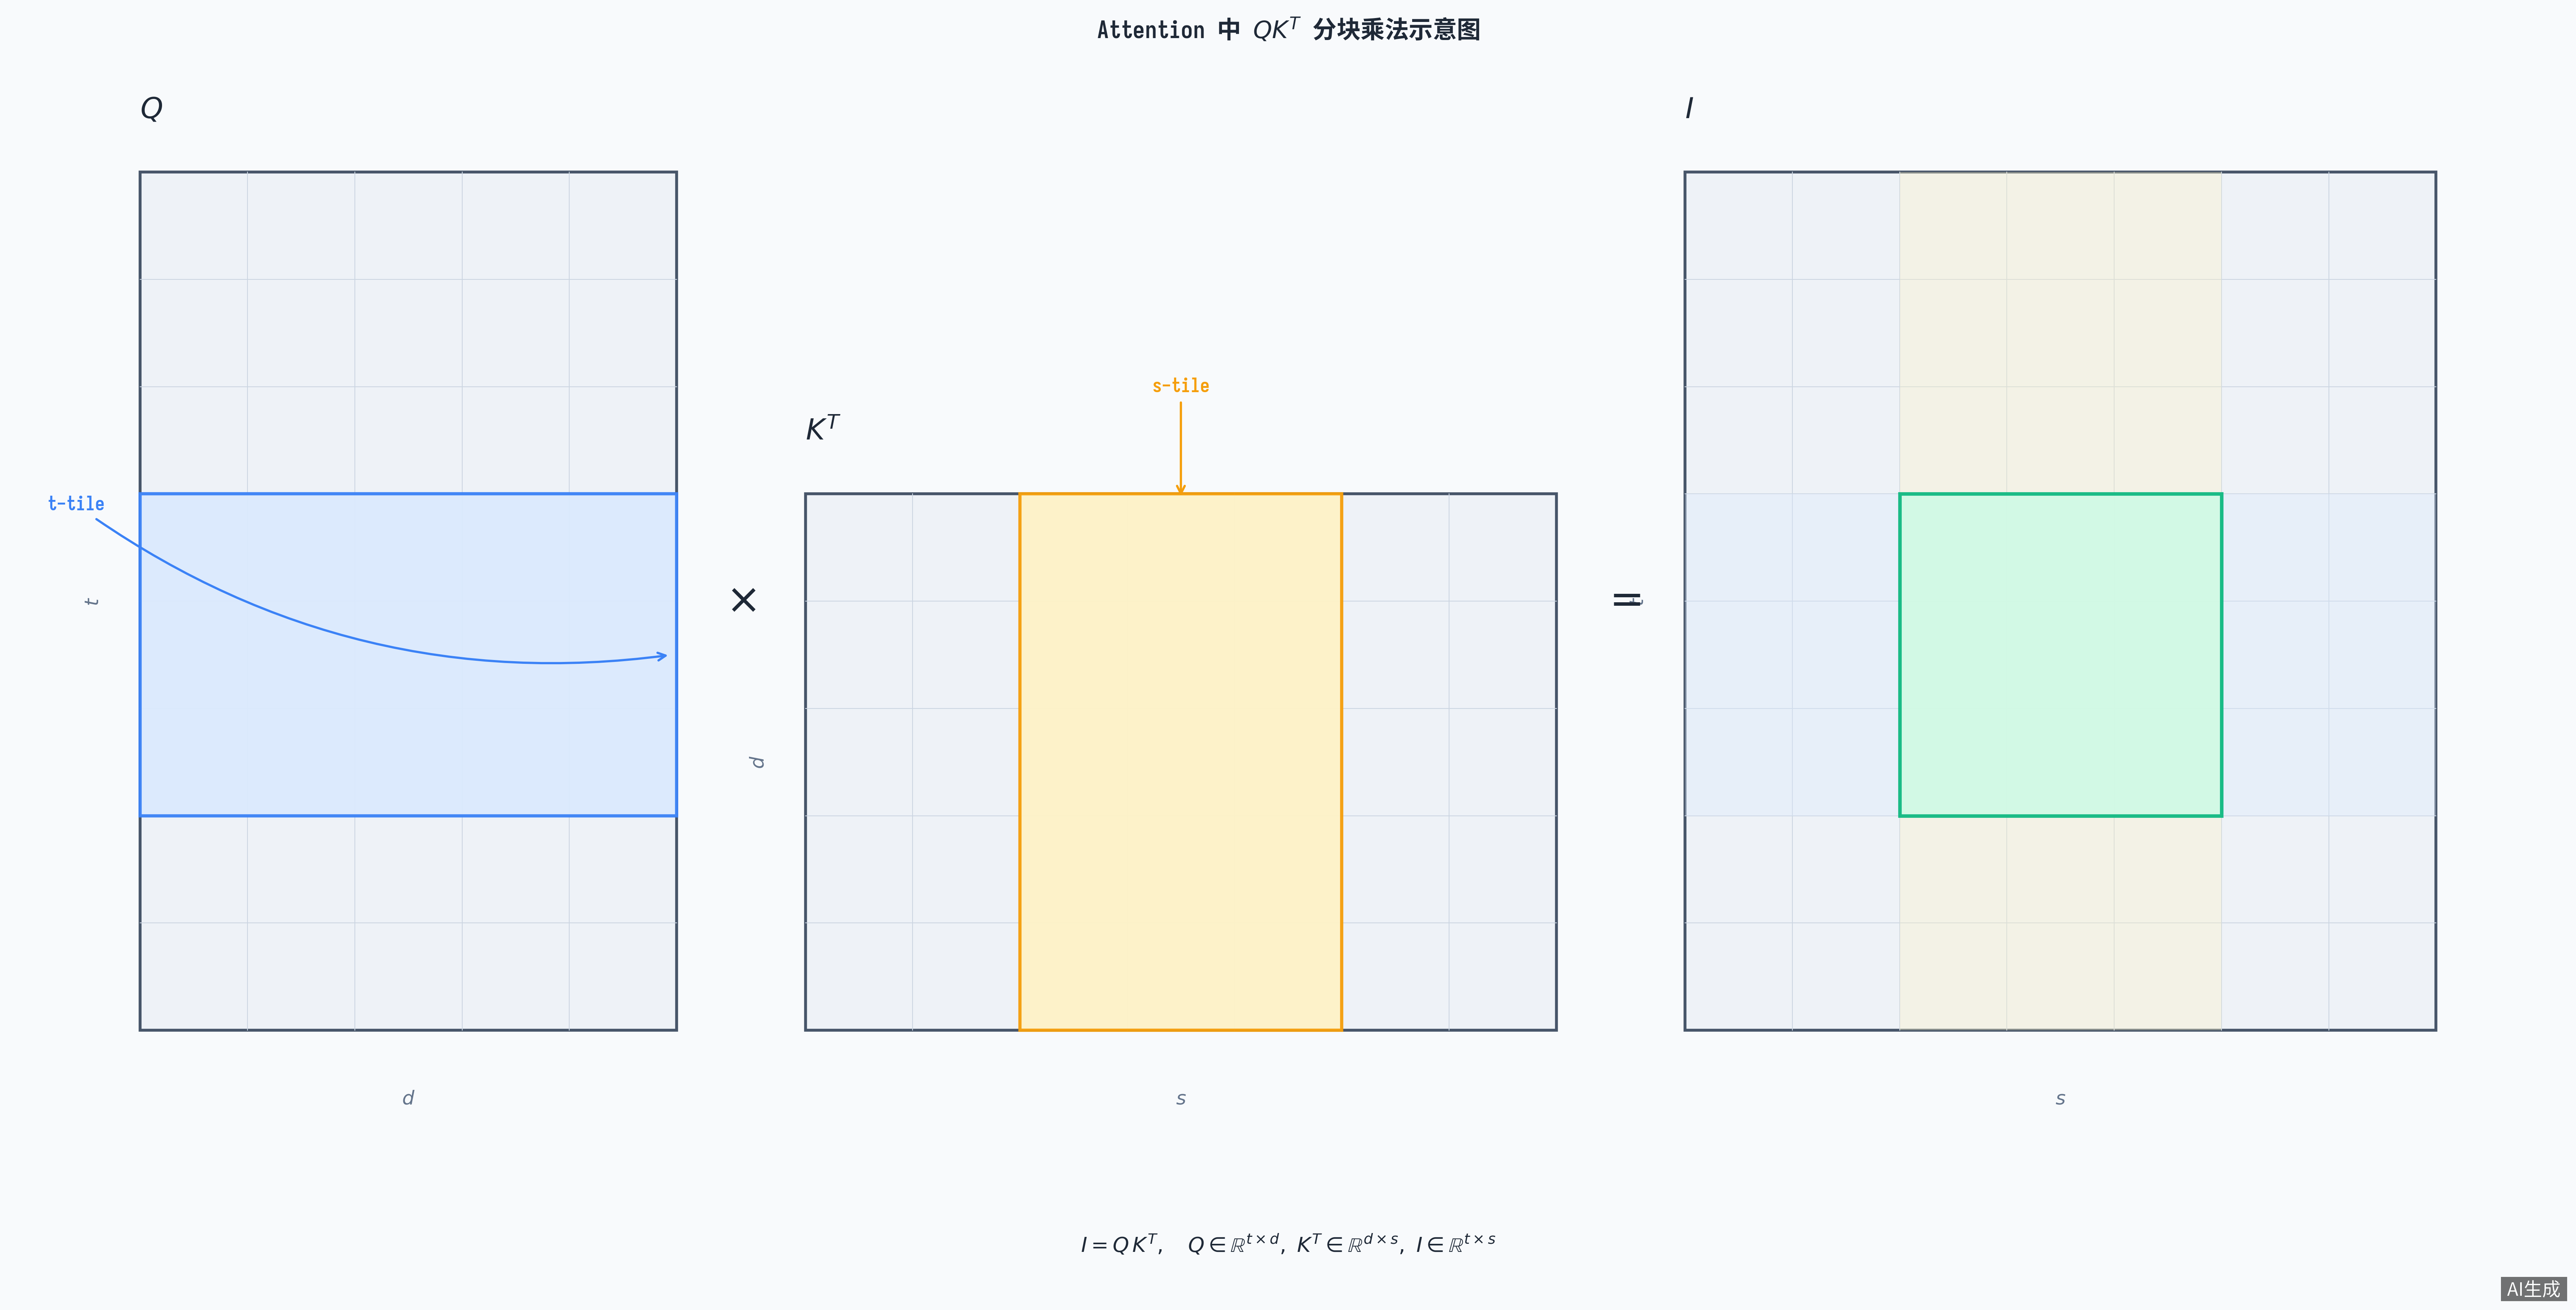
假设上面Q与K的转置相乘的所得矩阵为 I ,其维度为[t,s] (注意这里没有沿用上面的QKV都为[N,d]的例子),V矩阵的维度为[s,d]. 那么I矩阵在与V相乘之前需要经过一个 softmax操作。计算softmax 沿着的是s维,与softmax 的结果同V矩阵相乘的时候的收缩维度相同。
如果我们熟悉cuda 的kernel,例如矩阵乘法 kernel 编写,就能想到在计算矩阵相乘时的tiling 策略大致如下图:
在计算这个过程时,会遇到以下问题:
出于数学原理的考虑: 其中内积项 $I = QK^{T} \in \mathbb{R}^{t \times s}$ 的元素值会随 $s$ 线性增大。当 $s$ 较大时,$I_{ij}$ 可能达到几十甚至上百,此时直接计算 $\exp(I_{ij})$ 会遇到两个问题:
inf;为此引入 stabilized softmax:在计算 $\exp$ 之前,沿最后一维减去该行的最大值,从而把指数输入控制到 $(-\infty, 0]$ 区间,避免溢出,并提高数值精度。其公式为:
$$ \boxed{\;\operatorname{softmax}(\mathbf{x})_i = \frac{\exp(x_i - m)}{\displaystyle\sum_{j=1}^{N} \exp(x_j - m)},\qquad m = \max_{k} x_k\;} $$当然,可以证明其等价性: 减去 $m$ 后分子分母同除以 $\exp(m)$,结果不变:
$$ \frac{\exp(x_i - m)}{\sum_{j} \exp(x_j - m)} = \frac{\exp(x_i)\,/\,\exp(m)}{\left(\sum_{j} \exp(x_j)\right)/\,\exp(m)} = \frac{\exp(x_i)}{\sum_{j} \exp(x_j)} $$由于 $m = \max_k x_k$,故 $x_i - m \le 0$,即 $\exp(x_i - m) \in (0, 1]$,完全消除溢出风险,且不会改变 softmax 输出。 而在 Attention 中的应用如下: 设 $S = \dfrac{QK^{T}}{\sqrt{d}} \in \mathbb{R}^{N \times N}$,对其按行做 stabilized softmax,记 $m_i = \max_j I_{ij}$:
$$ \boxed{\;P_{ij} = \frac{\exp\!\left(I_{ij} - m_i\right)}{\displaystyle\sum_{k=1}^{N} \exp\!\left(I_{ik} - m_i\right)},\qquad P = \operatorname{softmax}\!\left(\frac{QK^{T}}{\sqrt{d}}\right)\;} $$出于工程实现的考虑: 通常情况(增量推理情况下,而非全量推理情况下)Q的t维可能比较小,而s维对于计算硬件的block单元来说可能比较大。而传统 softmax 的计算在 s维上算归一化,因此如果按照传统方式来算要在tiling的时候将完整的s维都塞进一个block中用于算输出的对应位置的值。 为此,引入 onlined stailized softmax 的计算方法:
Online softmax 的目标:逐块(tile)流入 $I$,逐块更新用于记录 max 的 m 和算出的每个位置的值 l,最终归一化,全程不需要把整行装入到 HBM。 关键的一点改进是利用了:当新的一块到来时,先前算的 $m$ 和 $\ell$ 可以被"修正",而不需要重新算整行。 设第 $i$ 行被划分为 $T$ 个块:$S_{i,:}^{(1)}, S_{i,:}^{(2)}, \dots, S_{i,:}^{(T)}$,每块长度 $B$。第 $k$ 块处理完后维护局部统计量:
对于局部最大值 的 更新不做解释。 解释一下修正全局指数和,以及 积累未诡异话的输出的过程:
新最大值出现后,历史指数和需要"重新缩放"——之前是按 $m_{\text{old}}$ 减去的,现在要换成 $m_{\text{new}}$:
$$ \boxed{\;\ell_{\text{new}} = \underbrace{\ell_{\text{old}} \cdot \exp\!\big(m_{\text{old}} - m_{\text{new}}\big)}_{\text{历史项重新缩放}} \;+\; \underbrace{\ell^{(k)} \cdot \exp\!\big(m^{(k)} - m_{\text{new}}\big)}_{\text{当前块的重新缩放}}\;} $$累积未归一化的输出: 由于 $P_{ij} = \exp(S_{ij} - m_i)/\ell_i$ 中的分母 $\ell_i$ 在最后一刻才确定,过程中只累积分子。设 $O_i$ 为第 $i$ 行的未归一化输出(与 $V$ 的乘积),则:
$$ O_{\text{new}} = O_{\text{old}} \cdot \exp(m_{\text{old}} - m_{\text{new}}) \;+\; \left(\sum_{j \in \text{block}_k} \exp\!\big(I_{ij} - m^{(k)}\big)\, V_{j,:}\right) \cdot \exp\!\big(m^{(k)} - m_{\text{new}}\big) $$于是,最终归一化: 所有块处理完后,得到完整的 $m_{\text{final}}, \ell_{\text{final}}, O_{\text{final}}$,做一次除法即得输出:
$$ \boxed{\;\text{Output}_i = \frac{O_{\text{final}}}{\ell_{\text{final}}}\;} $$如此,可以分块计算各个块的softmax,然后逐步根据新找到的最大值更新,而不需要采用激进的 tiling 方式将过多的数据一次性塞入 tile 中。